Imaginemos por un momento la siguiente escena: le pides a tu asistente de voz que te lea las últimas noticias del sector tecnológico y, de inmediato, te ofrece un resumen impecable, citando fuentes, analizando tendencias y desglosando complejos algoritmos. Un prodigio de conocimiento. Acto seguido, le solicitas que te recuerde el nombre de aquel restaurante italiano que visitaste con tu pareja hace seis meses para una ocasión especial, y su respuesta es un frustrante: "Lo siento, no tengo esa información". O peor aún, te recomienda el mismo restaurante genérico de comida rápida de siempre, ignorando por completo el contexto emocional y personal de tu petición. Esta es la paradoja con la que convivimos a diario: la inteligencia artificial, capaz de dominar vastos repositorios de información especializada, a menudo parece sufrir de una amnesia selectiva cuando se trata de la vida del propio usuario. Recuerda el código, pero olvida tu vida, y la razón principal no es una limitación intrínseca de la IA, sino la forma en que el contexto de nuestros datos está intrínsecamente ligado al vendedor.
Vivimos en una era donde la conveniencia de los asistentes de IA es innegable. Desde configurar alarmas hasta controlar dispositivos inteligentes, su presencia se ha vuelto indispensable. Sin embargo, esta conveniencia viene con una fragmentación inherente de nuestra identidad digital, un laberinto de información dispersa a través de distintos servicios y plataformas, cada una controlada por un vendedor diferente. Google sabe de tus búsquedas y correos, Amazon de tus compras, Apple de tus dispositivos y sincronizaciones, y así sucesivamente. Cada uno construye un perfil de "ti", pero ninguno tiene el "tú" completo. Esta dispersión de contexto no es accidental; es, en muchos casos, un diseño deliberado que fomenta la dependencia y el llamado "lock-in" o cautiverio digital.
El dilema del "conoce todo" y "no sabe nada" de la IA
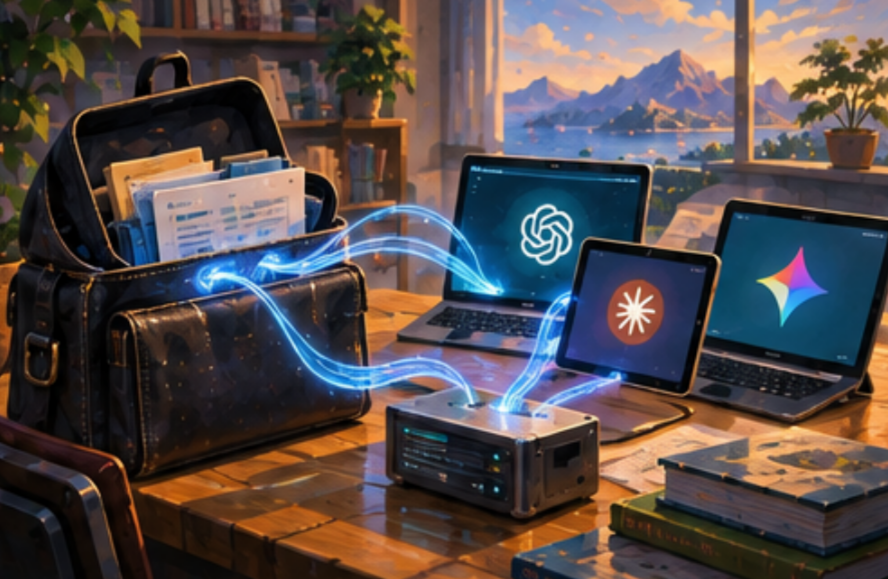
Nuestras interacciones con los asistentes de IA son un claro ejemplo de este dilema. Cuando le pides a tu asistente de Google que te recuerde el horario de tu vuelo, probablemente lo encontrará en tu calendario de Google o en un correo de Gmail. Si usas Siri y tienes tus citas en iCloud, obtendrá esa información. Pero, ¿qué sucede si parte de tu vida laboral se gestiona a través de Microsoft Outlook y Teams, mientras que tu vida personal se entrelaza con las aplicaciones de Google o Apple? De repente, tu asistente de IA, que es una extensión del ecosistema de un vendedor, se convierte en un experto en una parcela de tu existencia y un ignorante total en otra.
Esta limitación no proviene de una falta de capacidad de la IA para aprender y procesar información compleja, sino de barreras artificiales impuestas por los silos de datos de los vendedores. Cada empresa invierte miles de millones en desarrollar sus propios modelos de lenguaje y sus propios asistentes, entrenándolos con los datos que poseen o a los que tienen acceso con el consentimiento del usuario. Pero rara vez estos sistemas tienen la capacidad de interactuar fluidamente o de compartir contexto con los sistemas de la competencia. El resultado es una experiencia de usuario que es brillante en su esfera de influencia, pero frustrantemente limitada cuando el contexto se extiende más allá de sus fronteras. Me parece que, a menudo, los usuarios somos los grandes perjudicados en esta batalla por la cuota de mercado, sacrificando una experiencia fluida y verdaderamente inteligente en el altar de la competencia corporativa.
Consideremos, por ejemplo, el contexto de un desarrollador de software. Su asistente de IA podría ser excelente para recordar fragmentos de código, depurar errores en un entorno de desarrollo específico o incluso sugerir bibliotecas para un lenguaje de programación concreto. Podría estar integrado con su repositorio de Git, su IDE y su sistema de gestión de proyectos. Pero el mismo asistente probablemente no sabría que ese desarrollador ha estado trabajando jornadas extenuantes y que necesita un recordatorio para tomar un descanso, o que el patrón de sus hábitos de sueño ha cambiado drásticamente debido al estrés laboral, a menos que toda esa información también resida dentro del mismo ecosistema del vendedor. La IA recuerda el código, las dependencias y la sintaxis, pero se olvida de la persona que lo escribe, de sus necesidades y de su bienestar fuera del estricto dominio profesional. Este es un síntoma claro de un diseño que prioriza el dato del producto sobre el dato del individuo.
La fragmentación del yo digital: ¿por qué mi IA no me conoce?
La respuesta a la pregunta de por qué mi IA no me conoce de manera integral radica en la fragmentación de nuestra identidad digital. Nuestra vida, en el mundo conectado de hoy, se extiende por múltiples dominios: comunicación, ocio, trabajo, salud, finanzas, transporte. Cada uno de estos dominios, o al menos la mayoría de ellos, está mediado por aplicaciones y servicios proporcionados por diferentes empresas. Mi correo electrónico puede estar en Gmail, mis documentos en OneDrive, mis fotos en iCloud, mis compras en Amazon, mis citas médicas en un portal hospitalario específico, y mis interacciones sociales en diversas plataformas. La protección de datos personales es clave, pero ¿cómo se gestiona el flujo de estos entre plataformas?
Cada uno de estos proveedores, de forma legítima o no, construye un "modelo" de quién soy yo basándose en los datos que genero dentro de su ecosistema. El problema surge cuando intentamos consolidar estas diferentes facetas de nuestra vida digital en una experiencia cohesiva. Mi asistente de Google sabe lo que compro en Google Store, pero no lo que compro en Amazon, a menos que yo lo integre manualmente o le dé permisos específicos. Mi asistente de Apple sabe lo que hago en mi iPhone, pero no necesariamente lo que hago en mi ordenador con Windows. Esta compartimentación es el núcleo del porqué la IA, a pesar de su impresionante capacidad para recordar y procesar datos, falla en construir una visión holística de un individuo. No es una limitación cognitiva de la IA, sino una estructural, impuesta por la arquitectura del mercado digital.
El problema del contexto cautivo
El concepto de "contexto cautivo" se refiere a la situación en la que los datos y el contexto generado por un usuario dentro de un servicio o plataforma son propiedad o están bajo el control exclusivo del proveedor de dicho servicio. Esto crea una dependencia significativa. Si decido cambiar de proveedor de correo electrónico o de servicio de almacenamiento en la nube, la transferencia de mi contexto histórico (no solo los archivos, sino también las relaciones, las preferencias, los hábitos aprendidos por la IA) es, en el mejor de los casos, engorrosa y, en el peor, imposible.
Este contexto cautivo es un pilar fundamental en los modelos de negocio de muchos gigantes tecnológicos. El valor de sus asistentes de IA no reside solo en su capacidad técnica, sino en el vasto "jardín vallado" de datos de usuario que controlan. Un asistente de IA que tiene acceso a tu historial de compras, tus patrones de navegación, tus comunicaciones, tus citas y tus ubicaciones es, sin duda, más útil y "personal" que uno que no lo tiene. Sin embargo, esta utilidad viene a menudo a expensas de la libertad del usuario para elegir y de su capacidad para consolidar su propia identidad digital. Personalmente, encuentro este enfoque sumamente limitante para el potencial real de la IA y para la autonomía digital de los individuos. El Reglamento General de Protección de Datos (RGPD) ha avanzado en el derecho a la portabilidad de datos, pero la implementación práctica de un contexto verdaderamente interoperable aún está lejos.
La privacidad como moneda de cambio y el riesgo de los "jardines vallados"
En este ecosistema fragmentado, la privacidad se convierte en una moneda de cambio. Aceptamos los términos y condiciones, a menudo sin leerlos, y permitimos que nuestras interacciones y datos sean recolectados y analizados. A cambio, obtenemos la comodidad de servicios aparentemente gratuitos y asistentes que, hasta cierto punto, nos conocen. Pero, ¿a qué precio? La recopilación masiva de datos por parte de los vendedores alimenta sus modelos de IA, permitiéndoles ofrecer servicios más personalizados, sí, pero también reforzar sus "jardines vallados".
Los "jardines vallados" (walled gardens) son ecosistemas cerrados donde un solo proveedor controla la mayoría de los servicios y el flujo de datos. Apple con su App Store y ecosistema de hardware/software, Google con sus servicios de Android y web, y Amazon con su comercio electrónico y servicios en la nube son ejemplos prominentes. Dentro de estos jardines, la IA puede ser sorprendentemente eficiente, ya que tiene acceso a una gran cantidad de datos y un control unificado sobre el hardware y el software. Sin embargo, esta eficiencia se desmorona en los límites del jardín.
Implicaciones para el usuario y la sociedad
Las implicaciones de esta situación son profundas. Para el usuario, significa una falta de verdadera personalización fuera de un contexto limitado. También significa que la capacidad de "conocerte" de la IA está directamente ligada a tu compromiso con un vendedor específico. Si cambias de teléfono, de sistema operativo o de proveedor de servicios, tu "cerebro digital" debe empezar de cero en muchos aspectos, perdiendo el contexto acumulado a lo largo de los años.
Desde una perspectiva social, la concentración de datos y contexto en manos de unos pocos gigantes tecnológicos plantea preocupaciones significativas sobre el poder y la manipulación. La IA, alimentada por estos jardines vallados, puede influir en nuestras decisiones de compra, en la información que vemos e incluso en nuestras opiniones políticas, basándose en un perfil incompleto y potencialmente sesgado. La falta de interoperabilidad y la dificultad para exportar y recombinar nuestros propios datos limitan nuestra agencia digital y nuestra soberanía sobre nuestra propia identidad. La Electronic Frontier Foundation (EFF) a menudo aboga por una mayor soberanía del usuario sobre sus datos.
La propuesta: separación del contexto del vendedor
La solución a este dilema, y la clave para desbloquear el verdadero potencial de una IA centrada en el ser humano, reside en la separación del contexto del vendedor. Esto implicaría un cambio fundamental en cómo se conciben y diseñan los asistentes de IA y los servicios digitales. En lugar de que cada vendedor posea una porción de tu contexto, la idea es que el usuario sea el verdadero propietario y gestor de su propio contexto, de su "yo digital" unificado.
Imaginemos un sistema donde tu contexto personal (tus preferencias, tu historial de navegación, tus hábitos, tus relaciones, tus citas, tus datos de salud, tus proyectos, etc.) reside en un "vault" o bóveda de datos personal controlada por ti. Este vault no estaría atado a un vendedor específico, sino que sería un repositorio neutral, accesible para cualquier asistente de IA o servicio con tu permiso explícito y granular. Cuando interactúas con un asistente de Google, este podría solicitar acceso a tu historial de compras de Amazon almacenado en tu vault. Si usas un asistente de Microsoft para el trabajo, podría acceder a tus notas personales de un servicio de código abierto si le das permiso.
Este modelo no solo empoderaría al usuario al darle control sobre sus propios datos y su privacidad, sino que también fomentaría una competencia más sana entre los proveedores de IA. En lugar de competir por la posesión de datos, competirían por la calidad de sus algoritmos y la eficiencia con la que pueden procesar y utilizar el contexto proporcionado por el usuario. La IA dejaría de ser una extensión del vendedor para convertirse en una verdadera extensión del usuario. El proyecto Solid de Tim Berners-Lee es un ejemplo pionero de cómo podría funcionar la separación de datos personales.
Modelos de datos personales soberanos y portabilidad
La implementación de esta visión requeriría el desarrollo de modelos de datos personales soberanos y una mayor énfasis en la portabilidad de datos. Los datos personales soberanos implicarían que los usuarios no solo tienen derecho a sus datos (como lo estipula el RGPD), sino que también tienen la capacidad técnica y operativa para almacenarlos, gestionarlos y compartirlos de forma segura y granular. Esto podría tomar la forma de "Personal Data Stores" (PDS) o de identidades descentralizadas.
Técnicamente, esto podría materializarse a través de estándares abiertos y API interoperables que permitan que los datos fluyan de manera segura entre diferentes servicios, siempre bajo el control y consentimiento del usuario. La autenticación federada, los identificadores descentralizados (DIDs) y las credenciales verificables (VCs) son conceptos que podrían jugar un papel crucial en la construcción de esta nueva infraestructura. Pienso que, aunque la complejidad técnica es inmensa, la recompensa en términos de empoderamiento del usuario y de la creación de una IA verdaderamente útil justificaría con creces el esfuerzo. MyData Global es una organización que promueve el empoderamiento individual sobre los datos personales.
Desafíos y oportunidades para un futuro abierto de la IA
La transición hacia un modelo de IA donde el contexto del usuario está separado del vendedor presenta tanto desafíos monumentales como oportunidades transformadoras.
Desafíos:
- Complejidad técnica de la interoperabilidad: Crear estándares universales y sistemas seguros para la gestión y el intercambio de datos personales entre plataformas dispares es una tarea formidable. Requiere una colaboración sin precedentes entre empresas, desarrolladores y organismos reguladores.
- Modelos de negocio arraigados: Muchos de los gigantes tecnológicos actuales basan su rentabilidad en la recolección y monetización de datos. Adoptar un modelo donde el usuario controla su contexto significaría una revisión fundamental de sus estrategias de negocio, algo a lo que podrían oponerse activamente.
- Seguridad y privacidad: Centralizar el contexto del usuario, incluso si es bajo su propio control, plantea riesgos de seguridad significativos. Un "vault" de datos personales sería un objetivo muy atractivo para los ciberdelincuentes, y la implementación de sistemas de seguridad robustos sería crítica. La gestión de permisos granulares también es un desafío de UX complejo.
- Adopción del usuario: Para que un sistema así funcione, los usuarios deben estar dispuestos y ser capaces de gestionar su propio contexto. Esto requeriría interfaces de usuario intuitivas y una educación generalizada sobre la importancia de la soberanía de los datos.
Oportunidades:
- Asistentes de IA verdaderamente inteligentes: Con acceso a un contexto completo y unificado del usuario, la IA podría trascender sus limitaciones actuales y ofrecer una personalización y una utilidad sin precedentes. Podría recordar tanto el código como tu vida de una manera coherente.
- Competencia e innovación: Al democratizar el acceso al contexto del usuario (con su permiso), se nivelaría el campo de juego para los desarrolladores de IA. Pequeñas startups podrían competir con grandes corporaciones basándose en la calidad de sus algoritmos y servicios, no solo en la magnitud de sus bases de datos.
- Empoderamiento del usuario: Los individuos tendrían un control sin precedentes sobre su identidad digital, sus datos y cómo se utilizan. Esto fortalecería la privacidad y la autonomía en la era digital.
- Nuevos modelos de negocio: Podrían surgir nuevas empresas centradas en la gestión de datos personales, la seguridad de los "vaults" de datos, o la creación de servicios de IA que funcionan con contextos proporcionados por el usuario. La ética en la inteligencia artificial es un campo en constante evolución, y este cambio podría llevar a desarrollos más éticos.
En definitiva, la IA de hoy nos recuerda el código, pero se olvida de nuestra vida. Esta no es una falla intrínseca de la inteligencia artificial, sino un reflejo de cómo hemos estructurado nuestro ecosistema digital: fragmentado y centrado en el vendedor. La promesa de una IA verdaderamente asistente, que nos conozca de manera integral y que actúe en nuestro mejor interés, solo se hará realidad cuando separemos el contexto personal del control del vendedor. Este cambio requerirá un esfuerzo concertado de la industria, los reguladores y los propios usuarios, pero el resultado podría ser una era de inteligencia artificial mucho más útil, ética y, sobre todo, humana. Es hora de que el "tú" digital sea tan cohesionado y fluido como el "tú" en el mundo real.